文献综述用什么 AI?按找文献、读文献和组织综述选择
写文献综述不知道用什么 AI?本文将综述任务拆解为检索筛选、精读对比、逻辑组织与正文引用四个阶段,对比 Consensus、Elicit、Connected Papers 与 InkFount 的具体分工,并通过真实文献演示如何从阅读矩阵写出论证扎实、引用可核对的综述段落。
撰写文献综述时,许多研究者希望找到输入题目就能生成整篇论文的工具。现实中,文献综述没有一键生成全部的万能 AI,有效的方法是按“学术检索找文献、结构化抽取读文献、工作台综合组织与核对引用”进行工具分工;AI 承担筛选、提炼与辅助改写,作者负责核心阅读判断与逻辑比较。如果直接让通用大语言模型生成综述,容易出现捏造来源、曲解原意或简单拼接摘要的情况。在进入具体操作前需要明确:完成文献阅读与矩阵提炼后,可以在 InkFount 写作工作台 中搭建论文框架、按题名或标识码检索并核对引用,进而完成正文的改写与逐组审阅。
拆清综述阶段:工具分工与能力边界
文献综述是对特定研究问题的系统性评述,核心要求是围绕主题对已有研究进行分类、对比与批判性审视,建立研究之间的综合关联,避免将单篇论文摘要简单按顺序罗列。乔治梅森大学写作中心文献综述指南 明确提出,综述必须建立多项研究之间的综合分析。
完整的文献综述流程通常拆解为四个连续环节:
- 检索发现:依据核心词或种子文献,排查相关领域的经典文献与最新出版物;
- 精读与信息提取:提炼各研究的研究对象、实验设计、核心数据以及作者承认的局限;
- 矩阵对比:将多项研究放在同一张分析表中,横向比对结论分歧、适用条件与方法差异;
- 正文组织与引用核查:撰写论述段落,在论点旁标注真实出处,并核验文献条目字段。
没有任何单一工具能替代研究者完成上述全过程。通用语言模型无法自动保障引文真实性;学术图谱工具擅长呈现文献关联,但不负责正文篇章的学术论证;写作工作台则负责承接结构组织、引用维护与成文审阅。厘清这四个环节,才能合理选择对应的工具。
工具选型矩阵:找文献、读文献与写综述的具体候选
在实际科研中,研究者通常组合使用多款具备明确专长的工具(参考 Reddit 学术生产力讨论)。不同阶段的具体候选与使用边界如下:
| 阶段 | 候选工具 | 核心能力 | 适用场景 | 使用边界与注意事项 |
|---|---|---|---|---|
| 拓展检索与引文追踪 | Connected Papers | 基于引文网络与相似度算法构建文献关系图谱 | 从单篇关键种子论文出发,向前追溯理论源头,向后追踪衍生与相似研究 | 呈现的是元数据关联与聚类分布,不展示论文细节,不能代替全文筛选 |
| 问题提问与共识检索 | Consensus | 检索同行评审学术论文,根据研究结论归纳共识倾向 | 针对具有明确因果假设的科学问题,快速了解当前学界的总体支持比例 | 提炼依赖论文摘要与结论片段,复杂实验的前提限制仍需查阅原文核实 |
| 结构化提取与对比 | Elicit | 按设定问题批量提取文献的方法、样本量、核心结果与局限 | 快速构建多篇文献的横向对比表格,提取定量与定性参数 | 抽取依赖算法理解,可能遗漏关键上下文,表格内容须逐行核对原文 |
| 正文组织、引用与审阅 | InkFount | 提供一至三级标题与斜杠命令、按题名/DOI 检索真实文献加入引用、选区 AI 对话并逐组审阅改动 | 搭建正式综述结构、规范插入自动编号引用、对初稿段落做精简与润色 | 依托学术搜索引擎添加文献,单次处理一条记录;AI 修改需登录、云端稿件与足够余额 |
选型原则很明确:找文献阶段依靠图谱和学术搜索引擎建立候选清单;读文献阶段依靠结构化抽取工具搭建对比表格;写综述阶段则转入研究型写作工作台,把经过核对的事实串联为合规段落。
实操示范:用同一组公开文献完成检索与结构化阅读
以“科学数据共享与科研复现困境”这一研究议题为例,演示如何使用三篇公开文献,完成从学术检索到阅读矩阵的提炼过程。
选取的真实文献记录包括:
- 文献一:Wilkinson 等(2016),提出数字资产管理的 FAIR 原则,刊载于《Scientific Data》,DOI 记录为 10.1038/sdata.201618。
- 文献二:Baker(2016),针对 1,576 名科研人员进行调研,探讨学界对实验不可复现现象的认知,刊载于《Nature》(DOI: 10.1038/533452a)。
- 文献三:Tenopir 等(2015),跨生命科学、物理科学与社会科学的大样本实证调查,分析数据共享行为与顾虑,刊载于《PLOS ONE》(DOI: 10.1371/journal.pone.0121112)。
产物一:检索结果核验记录
通过学术检索获取条目后,首先核查元数据是否完整:
- Wilkinson et al. (2016):出版状态明确,属于数据管理领域的方法与规范类文献。该文提出数据应具备可发现性(Findable)、可访问性(Accessible)、可互操作性(Interoperable)与可重用性(Reusable)。
- Baker (2016):调查类论文,样本量为 1,576 人。该文揭示科研群体对复现失败的普遍认知,指出数据与实验步骤不透明是造成不可复现的重要原因。
- Tenopir et al. (2015):实证统计类论文,样本量为 1,329 人。该文记录学者对数据共享的实际意愿,指出尽管大多数人认同共享价值,但实际提供完整原始数据的比例有限。
产物二:结构化阅读矩阵
获取文献后,应当提取关键维度的对比信息并汇总成表格,避免由模型直接拼凑零散结论:
| 文献标识 | 研究对象与样本规模 | 核心研究方法 | 主要发现 | 研究局限 | 与综述主题的对应关系 |
|---|---|---|---|---|---|
| Wilkinson et al. (2016) | 科学数据、元数据与算法基础设施 | 学术共同体框架制定与原则推演 | 确立机器可读的 FAIR 四大原则,强调元数据标准与持久标识符的必要性 | 属于规范性理论框架,未对各学科落实的成本与合规阻力提供实证测试 | 为数据标准化管理提供通用规范依据 |
| Baker (2016) | 1,576 名跨学科科研人员 | 问卷调查与描述性统计 | 超 70% 受访者尝试复现他人实验失败,超 50% 无法复现自身实验;原始数据与代码缺失被列为首要技术阻碍 | 自愿填写样本可能偏向对复现问题关注度更高的学者,未严格控制学科配比 | 提供科研人员对复现危机感知与数据开放紧迫性的实证背景 |
| Tenopir et al. (2015) | 1,329 名自然科学与社会科学研究人员 | 问卷量表与跨学科方差分析 | 绝大多数研究者肯定数据共享能促进行业发展,但实际公开发表完整数据的受访者不足半数;缺乏时间、标准和回报机制是主要顾虑 | 依赖自我报告数据,不同科研机构与资助环境对受访者回答存在未观测干扰 | 揭示学者对共享价值的认知与实际行动存在落差,指出制度与工具障碍 |
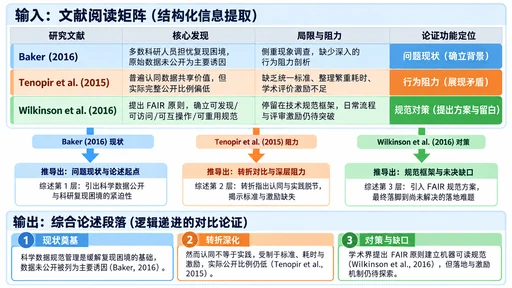
从矩阵中可以清晰看出:Baker 揭示了问题现状,Tenopir 解释了行动滞后的现实原因,而 Wilkinson 等人则给出了技术规范层面的解决方案。三者形成了互补的逻辑链条。
组织成文:从阅读矩阵到有可靠引用的综述段落
建立阅读矩阵后,撰写综述段落的目标是将表格中的对比关系转化为严密的学术论证,避免把每一行单独写成无关联的句子。
产物三:带正规引用的综述段落
基于上述矩阵,可以组织出如下综述段落:
科学数据的规范化管理与公开共享,被视作缓解科研复现困境的重要基础。调查显示,多数科研人员对实验不可复现的普遍性深感担忧,并将实验细节与原始数据不公开列为复现失败的主要技术诱因(Baker, 2016)。然而,认知层面的认同并不等同于共享实践的普及;实证研究表明,尽管跨学科研究者普遍肯定数据共享的科学价值,但受制于缺乏统一标准、整理耗时繁重以及缺乏学术评价激励,实际公开完整原始数据的比例仍处于较低水平(Tenopir et al., 2015)。针对共享标准与技术兼容性的断层,学术界提出了 FAIR 原则(Wilkinson et al., 2016),试图通过建立可发现性、可访问性、可互操作性与可重用性的机器可读规范,降低跨机构调用数据的门槛;但如何将规范性框架切实融入各学科的日常科研流程与评审激励机制,仍是文献中尚未充分解决的实践难题。
在写作工作台中落实引用与审阅
完成初稿构思后,读者可以将撰写任务转移至 InkFount 写作工作台 执行具体的文稿整理与引用核验:
- 搭建文稿结构:在主编辑区中使用一至三级标题组织引言、文献评述与研究设计各章节;在空段落键入
/命令,可快速调出标题、引用和表格等排版工具,保持长篇论文的层级清晰(参考 快速上手指南)。 - 检索并插入真实文献引用:在侧边文献面板中,输入论文 DOI(例如输入
10.1038/sdata.201618)检索官方出版记录。核验题名、作者、发表年份与出版来源后,点击“添加并引用”,即可在正文光标位置插入自动编号的文献标记,并将条目保存到当前稿件的参考文献列表中(参考 文献帮助文档)。需要明确的是,系统单次处理一条检索或 BibTeX 记录,条目存在仅证明有对应出版依据,引文是否能充分支撑作者观点仍须作者核实。 - 选区 AI 辅助修改与审阅:若需要精简综述段落的语言冗余,可选中该段文字,直接调出 AI 对话窗口,下达清晰指令:“精简重复词句,保留原有的三处文献引用标记与核心对比逻辑,不引入未提及的新事实”。AI 给出修改提议后,通过界面展示的修改前后对照,逐组核对文字改动,选择性接受或拒绝后确认合入正文(参考 AI 辅助功能说明)。该功能需要登录账户,在已保存到云端的文稿中消耗 AI 余额运行。
核查清单:发表前必须把关的四个文献综述底线
完成文献综述的草稿编写后,交付或投稿前应严格执行以下四项底线核查:
- 来源真实性核验:正文引用的每篇文献是否均具备真实出版记录、正式期刊卷期或合法 DOI?必须剔除通用大模型自发联想出的虚构文献条目。
- 论点与引文匹配度:正文对研究结论的归纳是否忠实于原文?检查是否把原作者限定在特定样本或特定条件下的结论夸大为普适结论,或者把相关关系误写为因果机制。
- 逻辑综合与对比深度:整篇综述是否围绕研究问题展开了跨文献的横向对比与辩证分析?段落间是否存在脱离主题的单篇文献摘要堆砌。
- 引用格式与编号连续性:正文中的所有引用编号与文后参考文献列表是否严格保持一一对应?在增删段落、移动图表后,检查引用编号是否保持连续更新。
继续阅读
这些相关文章可以帮助你补齐写作流程中的其他环节。
同一份材料写给不同读者,怎样调整研究报告的说明方式
面对同行评审与管理决策层,同一份研究报告该如何改写?本文剖析两类受众的核心阅读诉求,演示如何基于固定事实清单,借助 InkFount 的划词改写与前后对照审阅机制,调整叙述重心与术语深度,在守住数据真实性与因果边界的同时完成精准表达。
零散笔记怎么整理成文章:分类、提纲与分节起草示例
零散笔记怎么整理成文章?本文用一组包含事实与存疑数据的教学笔记,详解从分类标注、问题驱动归类、搭建分节提纲到工作台起草并补充真实引用的完整写前实操流程。
课题中期报告怎么写:进度、阶段成果与调整安排
系统解析课题中期检查报告的写作逻辑与结构:如何将实际进展与原计划对齐,严谨呈现阶段成果与图表,合理解释延期与方案调整,并在写作工作台中高效组织与交付。
在 InkFount 中实践这套方法
你可以直接在编辑器里搭建提纲、管理参考文献、插入引用,并在导出前完成结构与格式检查。