AI 论文润色怎么用?从一段原稿看保留原意的修改方法
AI 论文润色怎么用才能不改变原意?本文以一段具体研究讨论原稿为例,演示如何提交限定范围的改稿指令、对照修改前后差异、逐项审阅取舍并检查上下文衔接,提供可落地的学术润色工作流。
论文润色的核心在于学术事实与严谨论断的准确传递。AI 论文润色必须采取限定任务的逐段修改方式:通过明确约束保留事实与术语边界、比对前后差异、逐项审阅取舍,才能在提升表达的同时确保学术严谨性不受损害。在研究型写作工作台 InkFount 中,作者可直接选定段落发起修改并核对差异。
为什么论文润色需要逐段进行?
将整篇论文或数千字的大章节直接提交给大语言模型,容易带来意想不到的修改偏差。长篇学术文本输入后,模型常出现过度压缩、删减关键限定条件甚至重构核心论据的现象(Reddit 讨论)。更棘手的是学术立论的偏移:论文中常见的相关性描述、样本限制条件或审慎推论,极易被模型改写为绝对化的因果断言或夸大结论(Reddit 讨论)。
逐段修改将润色任务拆解为作者可控的单元。每一个段落都有其承载的论证功能,或是交代实验样本,或是分析指标关联,或是探讨潜在局限。把修改范围限定在单个自然段内,作者既能给出针对应有学术边界的明确约束,也能集中精力审查句间微调对原意的影响,防止文本在全局重写中偏离严密性。
准备原段与设定明确的修改目标
进行逐段润色前,需要界定该段在论文中的具体论点,并列出不可更改的信息边界。以下是一段典型的实证研究讨论段落(演示示例):
“在本研究采集的 128 份样本数据中,两项评估指标呈现出中度正相关(r = 0.42, p < 0.01),但由于本实验属于横断面观察设计,尚不能据此直接推断两者之间存在明确的因果机制 [1]。现有文献亦提示类似指标受多重混杂因素干扰 [2]。”
该原段存在句式连接平淡、书面语表达偏松散的问题。作者希望增强学术行文的紧凑感,但在发起修改前,必须划清四道不可退让的事实边界:
- 样本范围与统计参数:128 份样本、r = 0.42、p < 0.01 必须原样保留,不得模糊为“多数样本”或“显著数据”。
- 论断定性:本研究仅发现相关性,因实验设计限制不可推断因果关系。
- 参考文献与对应关系:引用标记 [1] 与因果推断限制绑定,[2] 与混杂因素干扰绑定,位置与对应关系不可错位。
- 规范术语:“横断面观察设计”、“中度正相关”与“混杂因素”必须保持专业命名一致。
提交限定范围的修改请求并比对结果
明确边界后,需要向模型提交带有排他性约束的指令,避免输入模糊的通用润色请求。
请润色以下选中的段落,目标是提升学术语言的严谨度与流畅度。
严格遵守以下约束:
1. 仅改善句式衔接与书面用词,严禁添加未提及的事实、机制或推论;
2. 完整保留样本数量(128 份)与统计数据(r = 0.42, p < 0.01);
3. 必须保留“相关性不能推断因果机制”的限定条件,严禁改写为因果结论;
4. 完整保留现有文献引用标记 [1] 与 [2] 及其对应的论述位置。
在 InkFount 的写作工作台中,作者只需在连续稿件中选中该段正文,调出 AI 审阅面板并粘贴上述指令即可发起请求(该功能需注册登录云端稿件,并依实际用量消耗 AI 余额;详见 AI 使用指南)。
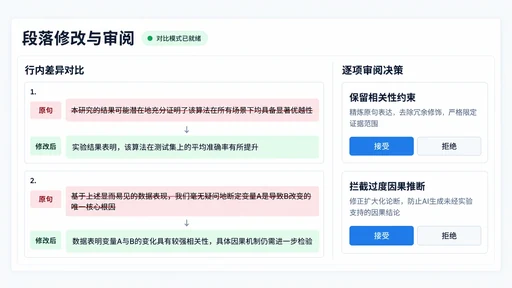
发起修改后,系统将生成候选修改并呈现差异比对。模型通常会针对不同句子提供不同的改写方向,以下为本次实操中产生的两组典型对比:
| 句段单元 | 修改提议 A(平整表述) | 修改提议 B(逻辑篡改) |
|---|---|---|
| 语句 1(数据与关联) | 基于本研究采集的 128 份样本数据,两项评估指标呈中度正相关(r = 0.42, p < 0.01)... | 本研究采集的 128 份样本数据证实,第一项指标显著促进了第二项指标的提升(r = 0.42, p < 0.01)... |
| 语句 2(局限与文献) | ...鉴于本实验采用横断面观察设计,当前数据尚不足以推断明确的因果机制 [1];且既有文献表明,相关指标易受潜在混杂因素的干扰 [2]。 | ...虽然实验存在一定局限,但这一因果关联值得进一步探索 [1]。 |
逐项审阅:作者如何决定保留与拒绝
面对比对视图,作者的职责是逐组审查语义变动,决定采纳或驳回。
对于语句 1,提议 A 优化了句首介词短语,去除了口语化的动词搭配,语言更为凝练,同时完整保留了样本量和相关系数,可以接受。提议 B 将中度正相关篡改为“证实...显著促进”,把统计层面的关联性篡改为实验层面的因果促进,产生了虚假论断,必须果断拒绝。
对于语句 2,提议 A 使用“鉴于本实验采用横断面观察设计”代替“由于本实验属于...”,增强了论述分寸感,分号后的衔接平顺自然,文献 [1] 和 [2] 的位置与支撑含义未受改动,符合采纳标准。提议 B 则删去了混杂因素说明,甚至将“不能推断因果”偷换为“这一因果关联”,直接削弱了讨论段落的严谨性,坚决予以拒绝。
在 InkFount 审阅界面中,作者对提议 A 点击“接受”,对提议 B 点击“拒绝”,系统便会将确认无误的表述组合写入正文。作者最终确认的定稿段落如下:
“基于本研究采集的 128 份样本数据,两项评估指标呈中度正相关(r = 0.42, p < 0.01)。鉴于本实验采用横断面观察设计,当前数据尚不足以推断明确的因果机制 [1];且既有文献表明,相关指标易受潜在混杂因素的干扰 [2]。”
经过逐项审阅,该段在提升行文规范的同时,学术边界与证据链条得到了完整保留。
应用修改后检查全文衔接与引用一致性
单段修改确认写入稿件后,整个润色流程并未结束。局部措辞的改动可能会影响与整篇论文的协调,作者需要执行三项回读核验:
核对前后段落的逻辑承接。单段语言精炼后,需要通读上一段结尾与下一段开头,检查上下文是否存在主语突变、因果断层或论述语气不协调的情况,确保过渡自然平顺。
统一核心学术术语。在润色过程中,模型有时会替换同义词。作者需要核对修改后的专业用词是否与引言、方法及结果章节保持一致,避免同一概念在全文出现不同的表述。
核验文献引用与编号有效性。在句式重构与分句调整后,必须检查引用标记 [1] 和 [2] 的标注位置是否依然精准对应原始观点的出处;若正文引用次序发生微调,需确认文末文献列表与正文标注保持对应。
完成复核后,该段润色才算真正交付完成。通过边界限定、逐项比对与上下文回验,作者便能在借助 AI 优化语言的同时,守住学术论文的真实性与严谨底线。
继续阅读
这些相关文章可以帮助你补齐写作流程中的其他环节。
同一份材料写给不同读者,怎样调整研究报告的说明方式
面对同行评审与管理决策层,同一份研究报告该如何改写?本文剖析两类受众的核心阅读诉求,演示如何基于固定事实清单,借助 InkFount 的划词改写与前后对照审阅机制,调整叙述重心与术语深度,在守住数据真实性与因果边界的同时完成精准表达。
零散笔记怎么整理成文章:分类、提纲与分节起草示例
零散笔记怎么整理成文章?本文用一组包含事实与存疑数据的教学笔记,详解从分类标注、问题驱动归类、搭建分节提纲到工作台起草并补充真实引用的完整写前实操流程。
课题中期报告怎么写:进度、阶段成果与调整安排
系统解析课题中期检查报告的写作逻辑与结构:如何将实际进展与原计划对齐,严谨呈现阶段成果与图表,合理解释延期与方案调整,并在写作工作台中高效组织与交付。
在 InkFount 中实践这套方法
你可以直接在编辑器里搭建提纲、管理参考文献、插入引用,并在导出前完成结构与格式检查。