论文结果怎么写:图表里的数字没错,文字为什么仍可能误导读者
论文结果段常陷入“数字无误却误导读者”的误区:文字遗漏比较基线,或把相关性夸大为因果。本文用一组教学实验数据,拆解结果段三层核对标准,演示在同一稿件中利用交叉引用保持图文编号联动,并向AI下达保留条件的修改指令与对比审阅。
数字明明没错,文字为什么仍会误导读者?
许多科研写作者常有一种误解:只要制图软件生成的曲线和柱状图数据真实、统计检验无误,论文的结果部分(Results)就天然具备了严谨性。然而在同行评议中,审稿人经常给出的尖锐意见往往是:“文字结论夸大了图表支持的事实”。
图表呈现的是客观测量值,而读者的理解完全依赖正文的引导。依据 ICMJE 稿件准备指南,结果部分应当按逻辑顺序呈现重要发现,提供确切数值与统计条件,而非脱离上下文机械堆砌数据;Purdue OWL 实验报告写作指南 同样强调,Results 的职责是客观报告“发现了什么”(what was found),必须严禁脱离实验约束提前展开主观推断。
文字对读者的误导通常不是算错数字,而是来自两个隐蔽的表达漏洞:一是隐去对比基线与适用条件,把局部条件下的优势叙述为通用表现;二是跨界越位,将单纯的数据关联直接写成因果定论。
三层核对标准:分清观察、条件与机制推断
要写出客观准确的结果段,写作者需要明确区分三个层级:客观观察、限定条件与机制推断。我们可以通过一组教学模拟实验来看看文字如何产生偏离。
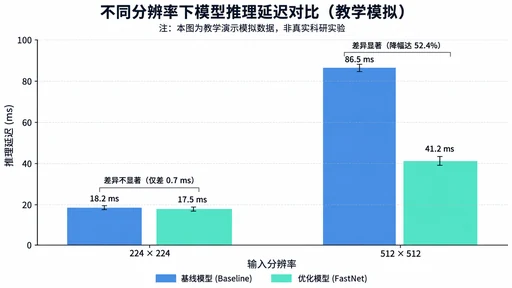
下表展示了一组算法推理性能对比的测试记录(注:本案例为教学模拟数据,非真实科研实验):
| 测试模型 | 输入分辨率 | 推理延迟 (ms) | 显存占用 (GB) |
|---|---|---|---|
| 基线模型(Baseline) | 224 × 224 | 18.2 ± 0.5 | 1.2 |
| 优化模型(FastNet) | 224 × 224 | 17.5 ± 0.4 | 1.1 |
| 基线模型(Baseline) | 512 × 512 | 86.5 ± 2.1 | 4.8 |
| 优化模型(FastNet) | 512 × 512 | 41.2 ± 1.3 | 2.1 |
初稿中常见的结果段往往写成这样:
问题示例(教学错例):“如测试结果所示,我们提出的 FastNet 实现了高达 52.4% 的推理速度提升,证明了轻量化注意力机制能显著加速特征提取并彻底解决显存瓶颈。”
用三层标准核对这段文字,问题一目了然:
- 客观观察(Data Observation):在 512×512 分辨率下,延迟确实从 86.5 ms 降至 41.2 ms,降幅为 52.4%。数字本身准确。
- 限定条件(Boundary Conditions):该提升仅在 512×512 高分辨率输入时存在;而在常规的 224×224 分辨率下,两者延迟仅相差 0.7 ms,差异并不显著。原文省略了分辨率条件,让读者误以为 FastNet 在所有场景下都能获得超过 50% 的提速。
- 机制推断(Mechanism Inference):“证明了轻量化机制加速特征提取”属于内部机理解释,且“彻底解决显存瓶颈”属于主观夸大修辞。
在论文规范中,结果部分只负责忠实陈述数据现象。至于为什么高分辨率下提速更显著、其理论机制是什么,必须严格留给讨论部分(Discussion)展开,不能在结果段提前预支。
调整图表顺序时,怎样防止正文引用脱节?
除了描述维度的失真,长篇论文修改时的“图文脱节”也是常见的低级错误。随着审稿意见或篇幅调整,作者经常需要增删图片或调换图表展示顺序。如果正文中全是手动敲入的“如图 1 所示”,图表移动后极易遗漏修改,导致正文引用的编号与实际图表张冠李戴。
在写作阶段,正文与图表应当在同一工作流程中管理。在学术写作平台 InkFount 中,上传图表并填写图题后,正文可以通过“插入 → 交叉引用”直接绑定目标图表(参见 InkFount 图表与交叉引用帮助)。
使用交叉引用时,“如图”“见表”等中文叙述由作者输入,编号数字则由系统动态生成。当你在稿件前面插入新的实验架构图或调整图表前后顺序时,正文中引用的图表编号会自动同步更新,从排版机制上避免了手动核对数字的人为疏漏。
用 AI 润色结果时,如何约束它保留限制条件?
面对表述欠妥的结果段,许多作者会尝试使用 AI 润色。但如果仅给出“请帮我润色得更专业”这类模糊提示,大模型往往会顺着原句的夸张倾向,生成更多诸如“实现了突破性飞跃”“充分证实了优越性”等学术禁忌词汇。
要得到严谨的结果描述,必须向工具下达带有边界约束的明确指令。在 InkFount 中打开稿件后,可以选中上述问题段落,将其加入 AI 对话窗口,并提出具体要求:
“请精简这段文字,严格基于数据陈述。完整保留 512×512 与 224×224 两种分辨率下的对比数值与适用条件;删去‘高达’‘彻底解决’等夸大词汇;不作未经测试的内部机制推论,只客观描述测试结果本身。”
AI 处理后,作者不能全盘盲从,而是应当依托修改前后对照进行逐组审阅(参见 InkFount AI 对话帮助):
AI 提议版本:“在 512 × 512 输入分辨率下,FastNet 将推理延迟从 86.5 ms 降至 41.2 ms(降幅 52.4%),显存占用由 4.8 GB 降至 2.1 GB;但在 224 × 224 分辨率下,两者延迟差异不明显(17.5 ms vs. 18.2 ms)。这表明模型在复杂场景下具有良好的适应性。”
面对这一提议,作者的审阅取舍应当是:
- 接受前半部分:AI 准确补齐了不同分辨率的对照数值,去掉了无依据的绝对化修饰,客观呈现了数据在不同条件下的差异;
- 拒绝末尾衍生句:“这表明模型具有良好的适应性”属于未经检验的定性推测,超出当前测试数据的支撑范围,作者应予以拒绝或删除,保持结果段的纯粹客观。
动笔实操:带一组结果图文完成一致性核验
撰写论文结果段时,不妨对照以下清单自检:
- 核对基线:文字提及相对变化比例时,是否明确写出了绝对数值与对照基准?
- 标明边界:该数据表现是否仅在特定温度、浓度、分辨率或超参数下成立?是否已明确限定?
- 划清界限:文字是否克制在“测到了什么”,将“为什么会这样”的机制探讨留给了讨论部分?
- 图文关联:正文中的所有图表指向是否均有动态编号保护,避免调图后编号错位?
完成严谨的结果描述需要作者对数据边界保持清醒的审慎。你也可以带上一张近期绘制的结果图与一段拟写的结果说明,进入 InkFount 体验图文协同的写作过程。登录账户后即可使用基础正文编辑、图表整理与交叉引用编号联动功能;若需要调用 AI 选区对比润色,需使用账户中的 AI 额度。借助受控的修改与对照审阅,让每一句写进论文的文字都经得起审稿人的严苛推敲。
继续阅读
这些相关文章可以帮助你补齐写作流程中的其他环节。
论文导出成功就能交了吗?用源稿与成稿对照检查关键内容
论文导出成功不等于达到提交标准。本文以同一份小型学术样稿在 InkFount 中的导出案例为线索,梳理作者信息、图表公式、交叉引用及参考文献的源稿成稿四步对照法,阐述显示异常的源稿修正路径与匿名提交专项核验,帮助科研作者在交付前排除隐性差错。
论文讨论怎么写:遇到与预期不一致的结果,如何用文献展开解释
实验结果与预期冲突甚至反常下降时,讨论部分怎么写?本文通过一个真实文献支撑的教学案例,演示如何比对研究条件提炼解释,借助文献检索核对与带保留对照的AI润色,写出有证据、有边界的严谨学术讨论。
师姐看完豆包润色的段落,只问了一句:这个结论哪来的?
用豆包润色论文后语言变流畅,却被导师或师姐追问“结论从何而来”?本文剖析AI论文润色中将“初步观察”拔高为“绝对定论”的常见陷阱,提供对象、条件、因果三步核查顺序与原句—问题句—修订句对照示范,并详解如何利用受控提示词及 InkFount 审阅工作台锁定论断强度,确保学术严谨。
在 InkFount 中实践这套方法
你可以直接在编辑器里搭建提纲、管理参考文献、插入引用,并在导出前完成结构与格式检查。