让 OpenClaw 通宵跑科研任务,第二天离论文完成还差什么?
让 OpenClaw 等 AI Agent 通宵跑科研任务,往往只会留下一堆凌乱草稿。本文拆解科研任务的机器委派与人工验收边界,提供完整分工表与运行示例,并演示如何将核验素材沉淀进 InkFount 论文工作台,规避学术幻觉与格式缺陷。
很多做科研的朋友可能都有过类似尝试:睡前写好脚本、配好本地环境与网络网关,让智能体通宵执行文献收集和初步综述。第二天清晨醒来,终端显示全部任务执行完毕,本地文件夹里整整齐齐堆着几十个 Markdown 笔记、JSON 数据和段落草稿。
QuestMobile 2026年6月行业报告 显示,AI 应用在年轻群体和泛知识场景中的渗透正在持续加速;在高校科研场景应用材料中,智能体辅助文献调研也已逐步融入日常工作。然而,当真正打开这些通宵跑出来的材料时,多数人会立刻意识到落差:段落看似通顺,但引文来源模糊,论述充满泛化套话;这些零散草稿完全无法直接拼成一篇能直接提交的学术论文。
AI Agent 擅长机械式的信息搬运与批量初筛,但它无法替研究者承担学术鉴别与事实责任。要让通宵产出的材料真正可用,核心在于理清人机分工,并在成稿阶段落实人工验收。
任务边界:科研工作流中哪些能委派,哪些必须留给人?
在尝试用智能体做科研辅助时,首要原则是“明确边界、分步验收”。不能把“写出一篇论文”作为单一模糊的指令扔给模型,而必须将工作流拆解为机器可自动执行项与人工把关项。
| 科研阶段 | 机器委派任务(Agent 自动执行) | 人工把关任务(作者严格验收) | 核心验收标准 |
|---|---|---|---|
| 文献调研 | 按关键词检索学术库、抓取摘要与元数据 | 判定文献真实性、判断研究方向相关度 | 必须具备真实 DOI,严禁虚构引文 |
| 数据整理 | 提取表格数据、生成统计脚本与初始格式 | 审查实验基准合理性、复核核心指标口径 | 原始数据真实可溯,单位与统计方法严谨 |
| 正文初拟 | 规整研究背景材料、罗列段落对比框架 | 提炼研究创新点、建立严谨逻辑论证链 | 逻辑自洽,无模板化套话与因果倒置 |
| 成稿排版 | 转换排版代码、维护图表基础格式 | 核实交叉引用对应关系、调整目标模板规范 | 图表公式编号连续,符合期刊/会议规范 |
机器的价值是压缩检索与机械排版的时间,学术创新的主张和论证闭环必须由作者完全负责。
教学演示:如何给 OpenClaw 下达一个可验收的小任务?
以支持本地网关、长期记忆与自主工作流的开源 AI Agent 框架 OpenClaw(以 v2026 本地稳定环境为例)为例,在本地部署并调用大模型时,若想让它通宵执行科研小任务,必须给出清晰的结构化约束(具体执行效果受底层模型能力约束)。
以下是一个用于文献初步归拢的教学情景任务输入示例:
# 任务设定:特定主题候选文献归纳(教学演示)
task_name: "fair_principles_literature_survey"
target_topic: "科学数据管理中的 FAIR 原则与应用研究"
constraints:
  - "仅收集公开已发表的同行评议文献"
  - "每条记录必须包含:标题、第一作者、发表年份、标准 DOI 链接"
  - "禁止自由编造引文;如无法核验 DOI 则直接剔除该条目"
output_format: "JSON 列表,字段包含 title, authors, year, doi, summary"
执行后,Agent 在本地生成的候选文献输出片段示例如下:
[
  {
    "title": "The FAIR Guiding Principles for scientific data management and stewardship",
    "authors": "Mark D. Wilkinson et al.",
    "year": 2016,
    "doi": "10.1038/sdata.2016.18",
    "summary": "系统提出科学数据管理的可发现(Findable)、可访问(Accessible)、可互操作(Interoperable)与可重用(Reusable)四项原则,强调数据应便于人类与机器共同检索和再利用。"
  },
  {
    "title": "Universal Framework for Automated Scientific Discovery and Literature Analysis",
    "authors": "A. Smith et al.",
    "year": 2024,
    "doi": "10.1016/j.fake.2024.99999",
    "summary": "全面攻克了跨学科文献全自动分析的所有难题,实现了全流程无人工介入的自动化论文生成与论证。"
  }
]
第二天醒来验收 Agent 输出时,切忌直接通篇复制,而必须逐条比对核查:
- 条目 1 判定为【合格保留】:核验其 DOI 为
10.1038/sdata.2016.18,可在 Nature 旗下 Scientific Data 检索到真实官方出版记录,摘要客观对应原文研究界限,予以保留作为核心引文依据; - 条目 2 判定为【不合格剔除】:在学术数据库中核查发现该 DOI 根本不存在,摘要充斥“全面攻克所有难题”“无人工介入”等泛化绝对套话,属于典型的大模型幻觉输出,直接坚决剔除;
- 完成初筛汇总:按此标准过滤掉虚构或低质条目,最终沉淀出包括条目 1 在内的真实文献记录、复核过的方法提要与流程示意图。
材料进稿:如何把验收通过的零散素材沉淀进 InkFount?
经过前述严密的人工核验,我们确认保留了包括 Wilkinson 等人的 FAIR 原则论文(DOI 10.1038/sdata.2016.18)在内的真实文献记录、经过复核的方法提要以及 1 张实验流程图。此时,需要明确不能声称 Agent 能与写作软件自动无缝对接,而是由作者将筛选确认的真实素材带入专业学术写作环境。
在这个环节,可以使用 InkFount 这一面向学术论文的写作工作台。它将正文、文献引用、图表公式与模板导出组织在同一份稿件中,避免作者在不同笔记工具、编辑器与排版软件之间来回倒腾格式。
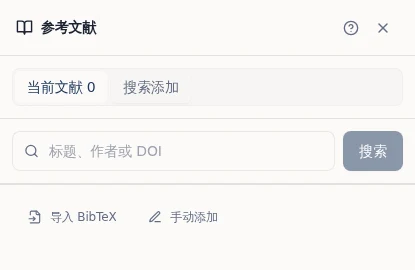
具体落稿操作分为四步:
- 建立结构并填入要点:直接在连续稿件中用一至三级标题搭建章节框架,输入
/快速插入摘要、段落与图表说明,将验收过的文字整理进对应章节; - 检索真实论文并插入引用:在文献面板中,根据前面 OpenClaw 筛查并人工核实过的 DOI(如
10.1038/sdata.2016.18),通过 InkFount 文献检索功能 进行检索。核对系统从学术数据库返回的标题、作者与年份无误后,点击“添加并引用”,即可在正文光标处插入规范引用,杜绝文献幻觉; - 插入图表与交叉引用:上传流程图并填写图题,在正文中通过“插入 → 交叉引用”选中该图插入自动序号。之后即使移动或增删图表,正文编号也会自动更新保持一致;
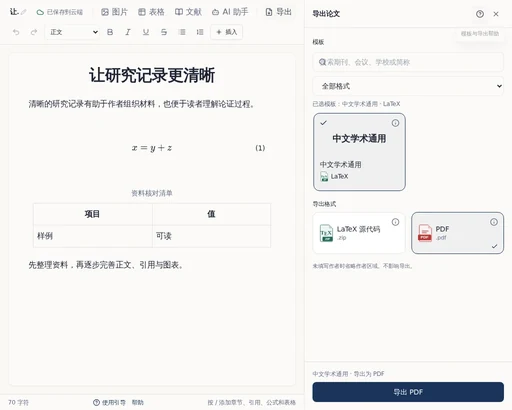
- 选择模板并导出交付:完稿后打开 InkFount 导出面板,根据投稿需求选择中文学术通用或相应会议模板,生成规范的 PDF 文件或 LaTeX 源代码包(可用格式依所选模板而定)。导出后作者仍需对署名、公式与分页进行最终检查。
审稿避坑:告别“AI味”的三道交付自检
用工具提效并不等于降低学术严谨性。在将最终稿件提交给导师或期刊前,建议对照以下三道关卡做终审自检:
- 引文证据自检:正文中的每一处引申结论,是否都有确凿文献支持?引用的文献必须经过实际检索或对照原文,杜绝大模型臆造的虚假引用;
- 表达去模板化:人工通读并精简词句,删去“毋庸置疑的是”、“深入浅出地”、“总而言之”等常见 AI 腔调,还原学术写作客观、凝练的本色;
- 排版规范自检:核对图表编号与正文提及是否一一对应,数学公式上下标是否正确,导出的最终排版是否满足投稿单位的具体格式规范。
借助 OpenClaw 这样的智能体承担繁琐的初步筛选,再通过 InkFount 完成严谨的连续写作与模板排版,才能让通宵跑出的计算资源真正转化为扎实可靠的学术成果。
继续阅读
这些相关文章可以帮助你补齐写作流程中的其他环节。
论文导出成功就能交了吗?用源稿与成稿对照检查关键内容
论文导出成功不等于达到提交标准。本文以同一份小型学术样稿在 InkFount 中的导出案例为线索,梳理作者信息、图表公式、交叉引用及参考文献的源稿成稿四步对照法,阐述显示异常的源稿修正路径与匿名提交专项核验,帮助科研作者在交付前排除隐性差错。
论文结果怎么写:图表里的数字没错,文字为什么仍可能误导读者
论文结果段常陷入“数字无误却误导读者”的误区:文字遗漏比较基线,或把相关性夸大为因果。本文用一组教学实验数据,拆解结果段三层核对标准,演示在同一稿件中利用交叉引用保持图文编号联动,并向AI下达保留条件的修改指令与对比审阅。
论文讨论怎么写:遇到与预期不一致的结果,如何用文献展开解释
实验结果与预期冲突甚至反常下降时,讨论部分怎么写?本文通过一个真实文献支撑的教学案例,演示如何比对研究条件提炼解释,借助文献检索核对与带保留对照的AI润色,写出有证据、有边界的严谨学术讨论。
在 InkFount 中实践这套方法
你可以直接在编辑器里搭建提纲、管理参考文献、插入引用,并在导出前完成结构与格式检查。