装了一堆科研 Skills 却被师兄问懵:为什么用 Claude Code 写论文还是停在空白页?
在终端装满了科研 Skills 和 MCP,用 Claude Code 写论文却迟迟写不出第一段?本文剖析工具配置与论文产出的落差,提供一套包含输入、指令与差异审阅的最小闭环实操,并对比 InkFount 可视化写作路径,帮科研人员打破空白页僵局。
实验室组会前的走廊里,常能看到这样的场景:师兄走过来拍拍肩膀问:“上周跑完的那组消融实验,Discussion 的初稿写出第一版了吗?拿来讨论一下。”
很多正尝试用 AI 辅助科研的同学瞬间卡壳。明明终端里刚刚配好了 Anthropic 的命令行智能体 Claude Code,本地环境装满了各种“科研Skills”和提示词脚本,甚至打通了几个文献检索插件。但一旦切到编辑窗口,光标依然在空白的 .tex 或 .md 文件上孤零零地闪烁。
为什么把工具链武装到了牙齿,却连能交差的第一段都写不出来?
配齐科研Skills,为何光标还在空白页闪烁?
许多人在搭建AI论文工作流时,容易陷入一种“配置即产出”的虚假满足感:花了两天时间研究各种论文写作Skills,在终端反复调试模型权限和自动化脚本,以为只要输入一句“帮我写一份目标检测模型的实验分析”,一篇符合学术规范的段落就会一键生成。
然而,一旦下达这种宏大模糊的指令,模型反馈的结果往往充斥着空泛的套话:“本实验取得了显著提升,验证了模型的有效性与鲁棒性……”看似流畅,实则毫无信息量。既不敢直接写进论文交给导师,又不知道该如何手动修正,最后只能删掉重来。
问题并不出在工具本身,而在于任务切分的方式。
学术论文的核心在于严谨的事实与逻辑链条。没有任何一种科研技能插件可以在缺乏原始实验观测的前提下无中生有。克服空白页的关键,不是去搜集更多神秘的 Skills 配置文件,而是把Claude Code写论文的任务颗粒度压缩到极致:用一段自己手写的不完美记录作为输入,下达高度收敛的修改目标,并在终端逐行审阅变化。
破局第一步:Claude Code 的最小修改任务
在终端环境中,更适合将 Claude Code 当作一个精确的文件编辑智能体,而非全自动论文写手。建立最小产出闭环只需要三步:输入粗糙笔记、限定具体指令、审阅终端差异。
1. 准备原始输入材料
不要让光标停留在空白文件上。先在本地新建一个临时草稿文件 draft_notes.txt,用最白话、甚至带点口语的文字,把自己刚刚完成的实验现象记录下来:
模型加了跨尺度注意力模块后,小目标的 mAP 从 32.4% 提到 35.1%,整体提升了 2.7 个点。
但是推理延迟也涨了差不多 14%,从 18ms 变成了 20.5ms。
主要是因为高分辨率特征图计算注意力太占显存和时间。
大目标上其实变化不大,mAP 几乎没动(从 58.2% 到 58.4%),说明这个模块主要还是对边缘细碎特征有帮助。
这段文字虽然不符合学术规范,但包含了最关键的真实要素:实验数值、正向收益、负面代价与归因推测。
2. 下达收敛的修改指令
在终端中启动 Claude Code,明确告知任务边界:保留全部数值与归因,仅调整行文规范,严禁凭空添加未提及的超参数或结论。
claude "读取 draft_notes.txt,将其改写为一段用于学术论文 Experiment Discussion 的规范英文,要求:
1. 严格保持原有数值(32.4%、35.1%、18ms、20.5ms 等)准确无误,不得捏造新的指标;
2. 采用客观学术语调,先阐述性能提升,再客观讨论延迟代价并给出归因;
3. 将改写结果直接输出并展示与原意对应的结构。"
3. 在终端审阅改动差异
Claude Code 读取上下文后,会返回对应的改写段落。此时的核心动作是论文润色审阅,作者必须逐句对照数值是否发生偏移:
To assess the impact of the proposed multi-scale attention module,
we conducted ablation experiments focusing on both detection accuracy and latency.
As shown in our evaluation, incorporating the module improved the small-object mAP
from 32.4% to 35.1% (+2.7%), while performance on large objects remained largely unchanged
(58.2% vs. 58.4%). This suggests that the attention mechanism predominantly enhances
fine-grained boundary representations. However, this gain incurred a 13.9% increase
in inference latency (from 18.0 ms to 20.5 ms), primarily attributable to the quadratic
computational cost when computing attention maps over high-resolution feature hierarchies.
通过这一套最小任务,你在五分钟内就拿到了一段包含具体数据、归因清晰且可直接放入正文讨论的成型段落。空白页被打破,工具也真正转变成了生产力。
另一条可视写稿路径:在 InkFount 审阅改动
终端命令行适合处理代码和纯文本脚本,但也有许多写作者并不习惯在黑底绿字的终端中反复做 diff 对比。尤其当论文进入图表排版、公式推导以及复杂的行内修改时,频繁在终端与外部阅读器之间切换会打断写作思路。
如果你更习惯所见即所得的写作方式,可以尝试另一条专门面向学术文稿的可视化路径——InkFount。它是一个将正文、文献引用、公式图表与模板排版整合在一起的在线论文工作台。
在 InkFount 中完成上述最小修改任务,操作直观聚焦在“选段、提问、核对差异”上:
- 粘贴原始文段:将草稿直接贴入正文编辑区,选中需要调整的那一段文字。
- 在上下文中提要求:唤起 AI 辅助面板,输入具体润色指令,例如“将本段改写为学术风格的讨论段落,保留原有对比数据,不要添加未经证实的事实”。
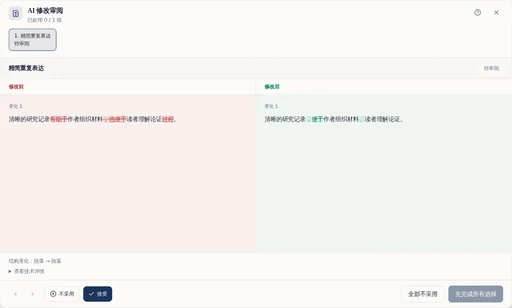
- 逐组审阅修改对照:系统不会直接覆盖正文,而是以并排或高亮形式展示修改前后的具体差异。作者可以逐句核对:术语替换是否恰当、数值是否准确无误。满意的改动点击“接受”,有偏差的点击“拒绝”,确认后才真正写入正文。
完成正文润色后,写作通常需要继续延伸到文献佐证与交付阶段。在 InkFount 中,作者无需切换到第三方工具手动拼接 BibTeX,可以直接打开参考文献面板,输入 DOI、论文标题或作者检索已发表的权威文献,核对信息后一键插入正文作为引用支撑;也可以手动维护或单条解析 BibTeX。最后,根据会议或期刊规范,在导出面板直接生成排版规范的 PDF 预览或 LaTeX 源码工程。
需要说明的是,InkFount 的 AI 辅助与多设备云端保存需要注册登录;AI 功能按实际使用的 Token 用量计费(需保持账户余额不少于 1 元),并非免费工具。平台提供的是受控的编辑辅助与排版交付环境,不提供“降重通过率保证”或“自动主张审计”,正文观点的科学性仍需作者本人把关。
终端代码流还是可视工作台?按需选择论文方案
面对终端写论文与可视写作环境,并不存在绝对的高下之分,关键在于你手头的工作流属性:
| 比较维度 | Claude Code 终端代码流 | InkFount 可视化写作工作台 |
|---|---|---|
| 工作环境 | 本地终端、命令行与 Git 仓库 | 网页浏览器、云端自动保存 |
| 适用底稿 | 纯文本、Markdown、已有本地 LaTeX 工程 | 连续图文排版稿件、学术规范长文 |
| 修改审阅方式 | 终端命令行输出、Git diff 或文件覆盖对比 | 界面可视化左右对比,支持逐组接受/拒绝 |
| 文献与公式 | 依赖本地 .bib 文件手动维护,LaTeX 手写公式 | 内置文献搜索引擎与单条导入,可视化公式与自动交叉引用 |
| 交付形式 | 本地编译生成 PDF,或通过脚本部署 | 依据内置学术模板一键导出 PDF 或 LaTeX 源码包 |
| 适合场景 | 习惯 Vim/VSCode、有复杂代码管理和脚本自动化的开发者 | 希望摆脱环境配置陷阱、专注正文撰写与排版交付的科研人员 |
如果你精通命令行,且论文工程与大量本地 Python 实验脚本、Makefile 紧密绑定,用 Claude Code 配合严谨的最小修改任务能最大化发挥本地环境的灵活性;而如果你被繁琐的宏包配置、Git 冲突和纯文本 diff 消耗了过多精力,只想尽快把实验笔记整理成结构完整、随时可交付的成文,转到 InkFount 的可视工作流中完成选段修改与审阅,会是更省心的选择。
归根结底,论文不是由华丽的 Skills 堆砌出来的,而是由一段段经过审阅的严谨文字组合而成的。关掉那些无休止的配置教程,输入手头的第一行实验数据,把任务拆到能逐句核对的大小,空白页自然就会被填满。
继续阅读
这些相关文章可以帮助你补齐写作流程中的其他环节。
论文导出成功就能交了吗?用源稿与成稿对照检查关键内容
论文导出成功不等于达到提交标准。本文以同一份小型学术样稿在 InkFount 中的导出案例为线索,梳理作者信息、图表公式、交叉引用及参考文献的源稿成稿四步对照法,阐述显示异常的源稿修正路径与匿名提交专项核验,帮助科研作者在交付前排除隐性差错。
论文结果怎么写:图表里的数字没错,文字为什么仍可能误导读者
论文结果段常陷入“数字无误却误导读者”的误区:文字遗漏比较基线,或把相关性夸大为因果。本文用一组教学实验数据,拆解结果段三层核对标准,演示在同一稿件中利用交叉引用保持图文编号联动,并向AI下达保留条件的修改指令与对比审阅。
论文讨论怎么写:遇到与预期不一致的结果,如何用文献展开解释
实验结果与预期冲突甚至反常下降时,讨论部分怎么写?本文通过一个真实文献支撑的教学案例,演示如何比对研究条件提炼解释,借助文献检索核对与带保留对照的AI润色,写出有证据、有边界的严谨学术讨论。
在 InkFount 中实践这套方法
你可以直接在编辑器里搭建提纲、管理参考文献、插入引用,并在导出前完成结构与格式检查。