用 Kimi 整理了论文摘要,为什么组会被问还是讲不清?
用Kimi读论文摘录了大量摘要,组会却依然讲不清细节?本文通过文献精读三句复述法与原文定位技巧,配合公开文献实战演示,教你把AI摘要转化为带真实引用的个人综述成稿。
在日常科研中,很多同学习惯用 Kimi读论文:把几十页的英文 PDF 上传,几秒钟就能生成一段条理分明的文献总结。笔记软件里摘录了几十篇摘要,看起来进度飞快。
但这种流畅感往往会在真实的学术交流中被击碎。设想这样一个常见的组会情景:你照着笔记里的要点汇报某篇经典文献,导师突然打断追问:“这篇文章为什么要挑这个基准做对比?作者自己指出的实验边界是什么?”这时,你盯着屏幕上的总结概括,脑中却一片空白。
为什么把摘要背得再熟,合上页面依然讲不清细节?
认清错觉:AI 摘要是“索引地图”,不是理解终点
出现这种窘境,根源在于混淆了“获取概貌”与“建立证据链”。
随着大语言模型在学术办公场景中的普及,AI 读论文极大降低了文献粗筛的门槛。然而,模型给出的总结通常是高度抽象的结论性叙述,它默认过滤掉了研究的推导逻辑、假设前提和反常数据。当你只是被动阅读模型总结时,大脑会产生一种“我已经读懂”的认知错觉。
要摆脱这种被动状态,必须把 AI 的角色重新定位为“带路向导”:不要让模型直接给出阅读结果,而是让它帮你指出关键论据在原文的哪一页、哪一节。
【传统被动阅读】
上传论文 → 复制AI宏观摘要 → 存入笔记 → 汇报/下笔时缺乏论据支撑

【主动定位流程】
快速概览 → 带着问题追问证据位置 → 回到原文核实条件 → 用自己的话写下复述卡
交付工具:单篇文献“三句复述卡”
要想彻底解决“读完论文不会写综述”的问题,关键在于完成从模型语言到个人学术语言的重构。建议在阅读每篇核心文献时,严格落实一张包含三个要素的文献精读卡:
| 要素 | 追问核心 | 提炼标准 |
|---|---|---|
| 1. 核心问题(Problem) | 作者究竟面对什么具体痛点,为何前人方案不奏效? | 必须具体到特定应用场景或理论断裂处,拒绝宽泛口号。 |
| 2. 关键方法与证据(Method & Evidence) | 方案的核心设计是什么?支撑结论的最硬核数据在何处? | 必须定位到原文的具体图表、公式或对比实验章节。 |
| 3. 适用边界与局限(Limitation) | 该方案在什么前提下才成立?作者承认了哪些不足? | 从 Discussion 或 Conclusion 中找出约束条件,这是学术严谨性的体现。 |
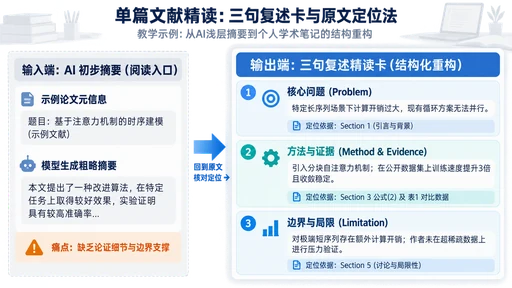
只要能用自己的白话把这三句话讲透,哪怕合上电脑,你也能清晰复述论文的骨架。
实战演示:从模型摘要到原文证据定位
下面以数据管理领域的公开文献——Wilkinson 等人发表于 Scientific Data 的 FAIR 原则论文(DOI: 10.1038/sdata.2016.18)为例,演示这一转化过程。该案例为教学情景演示(pending_demo)。
第一步:获取初步线索,反查关键主张
向模型提问后,AI 给出的摘要通常是:“该研究提出了科研数据应当遵循可发现(Findable)、可访问(Accessible)、可互操作(Interoperable)和可重用(Reusable)四大原则。”
如果仅停留在这一句,你并不知道它与传统数据共享有何本质区别。此时向模型追问:“作者强调这套原则的核心出发点是什么?对应原文哪个段落?”
第二步:回到原文核验证据
根据线索翻阅原文,在引言与设计理念部分,作者明确指出传统共享往往只面向人类学者,而该原则的核心目标是提升计算机系统的自动化处理能力(Machine-Actionability),因为海量数据的复杂性早已超出人工筛选极限。同时,在讨论部分,作者清楚说明该原则是指导方针(Guiding Principles),而非具体的实现规范或技术标准。
第三步:生成最终的精读复述
核对原文后,你落在卡片上的内容不再是空洞的原则罗列,而是扎实的三句话:
【问题】 传统科研数据多面向人工检索,缺乏统一元数据规范,导致算法和机器无法自动发现与高效复用海量数据。
【方法与证据】 原文系统拆解了 F、A、I、R 四大维度,明确要求为数据对象分配全局唯一持久标识符(PIDs),并在 Box 2 中给出了面向机器可操作性的细分准则。
【边界与局限】 FAIR 原则属于概念指导框架,原文明确不提供单一技术实现标准,各学科落地时仍需独立制定匹配的数据模型与接口协议。
转入写作:在 InkFount 中沉淀带引用的阅读小节
零散的卡片如果不及时归档进正文草稿,时间一长依然会遗忘。写文献综述最扎实的方式,是随读随记,把核实好的论据直接固化到写作工作台中。
打开 InkFount(面向学术论文的写作工作台),你可以在连续稿件中直接建立综述章节,将卡片内容变成带真实学术引用的正式论述:
- 建立阅读小节:在正文中创建如“2.1 科学数据管理原则的演进”等层级标题,将提炼好的三句复述内容作为段落骨架填入正文。
- 检索并插入真实引用:在需要标注文献依据的位置,打开右侧参考文献面板(参考 InkFount 文献操作指南)。在搜索框中直接输入目标文献的 DOI
10.1038/sdata.2016.18或英文题名,核对返回结果中的作者与年份后,点击“添加并引用”。系统会自动在正文光标处生成连续编号引用,并在文末同步生成标准规范条目;若手头已有现成的 BibTeX 代码,也可以在面板中单条粘贴解析录入。 - 扩写为自己的学术综述:基于确凿的原文依据展开对比评价,例如讨论后续研究如何在特定领域补充实现标准,自然完成综述正文的推进。
避坑总结:把控制权始终留在自己手里
利用工具速读文献不是偷懒的借口,而是为了将有限的精力集中在关键判断上:
- 核实优于轻信:无论 AI 工具总结得多顺畅,正文中引用的每一个核心事实、实验数据与局限,都必须亲自回到原文核对定位,坚决避免二手文献污染或引用幻觉。
- 复述先于动笔:如果无法脱稿讲出“问题-证据-局限”三要素,说明信息尚未真正被内化,切忌直接在正文里生硬拼凑模型生成的车轱辘话。
- 笔记即是正文初稿:借助 InkFount 等学术工作台,把每一次单篇精读的证据与引用同步锚定,日积月累,长篇文献综述自然水到渠成。
继续阅读
这些相关文章可以帮助你补齐写作流程中的其他环节。
论文导出成功就能交了吗?用源稿与成稿对照检查关键内容
论文导出成功不等于达到提交标准。本文以同一份小型学术样稿在 InkFount 中的导出案例为线索,梳理作者信息、图表公式、交叉引用及参考文献的源稿成稿四步对照法,阐述显示异常的源稿修正路径与匿名提交专项核验,帮助科研作者在交付前排除隐性差错。
论文结果怎么写:图表里的数字没错,文字为什么仍可能误导读者
论文结果段常陷入“数字无误却误导读者”的误区:文字遗漏比较基线,或把相关性夸大为因果。本文用一组教学实验数据,拆解结果段三层核对标准,演示在同一稿件中利用交叉引用保持图文编号联动,并向AI下达保留条件的修改指令与对比审阅。
论文讨论怎么写:遇到与预期不一致的结果,如何用文献展开解释
实验结果与预期冲突甚至反常下降时,讨论部分怎么写?本文通过一个真实文献支撑的教学案例,演示如何比对研究条件提炼解释,借助文献检索核对与带保留对照的AI润色,写出有证据、有边界的严谨学术讨论。
在 InkFount 中实践这套方法
你可以直接在编辑器里搭建提纲、管理参考文献、插入引用,并在导出前完成结构与格式检查。