增删段落后引用编号变了:怎样确认正文仍指向正确文献
论文增删或调换段落后引用编号变了怎么办?本文解析顺序编码制下引用重排规则,以真实文献与教学短稿演示如何利用 InkFount 维持正文与文献元数据的动态指向,并提供改写后核对事实支持度的三步核查清单。
编号变了,并不意味着引用出错
论文大修、重组章节或删改段落后,许多作者会发现正文里的引用角标变了:原本熟悉的 [1] 变成了 [2],文后的参考文献列表也跟着换了座次。这种变动常常引起慌乱——作者下意识会怀疑是不是排版系统出了故障,或是文献引用在移动过程中发生了错位。
事实上,绝大多数学术期刊与学位论文规范采用的都是“顺序编码制”。这种规则的核心在于:正文中的引用序号并不属于某篇文献本身,而是该文献在正文中首次出现位置的动态投影。只要你调换了段落顺序,在前面新增了包含新引用的句子,或者删除了某处原本排在最前的引文,整个稿件的编号序列发生平移重排是完全符合学术规范的正常结果。
真正需要警惕的不是“数字变了”,而是另外两件事:正文处的引用标记是否仍绑定在正确的文献元数据上?以及,被你改写后的句子,原文献是否还能提供有效支持?
为什么手写编号在大修时必然断裂?
有些作者习惯在草稿中直接手打上标数字 [1]、[2],并在文末手动敲出参考文献条目。这种做法在初稿单向线性写作时看似直接,但在结构调整时会立刻引发引用链条的断裂。
手写的静态数字与文后的文献条目之间不存在任何程序化的映射绑定。当你把后面章节的一个段落剪切粘贴到引言开头时,文本里的数字 [5] 不会自动根据新位置重排。如果作者试图手动逐个修正:
- 必须逐一顺延全文所有编号,极易出现漏改、跳号或重号;
- 一旦多处复用了同一文献,改动其中一处极易遗漏其余对应位置;
- 最严重的隐患在于,由于精力全被繁琐的数字加减所消耗,作者往往无暇顾及某个被移走的手写数字究竟对应哪篇论文,最终导致正文“指鹿为马”。
要从根本上避免这种混乱,关键在于将“文献实体”与“显示编号”解耦:正文插入的应当是文献的元数据实体,而数字序号则由系统按出现顺序自动计算。
在实际改稿中观察引用如何自动重排
为了观察段落重组时引用的实际变动规律,我们可以借助两篇公开可查的真实文献与一段教学短稿进行验证:
- 真实文献 A:Vaswani 等人于 2017 年提出的 Transformer 架构论文(arXiv:1706.03762);
- 真实文献 B:Devlin 等人于 2018 年提出的 BERT 模型论文(arXiv:1810.04805)。
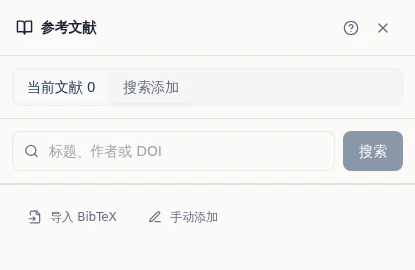
在论文写作工作台 InkFount 中,登录后可以通过标题、作者或 DOI 检索学术论文,核对元数据后直接添加到稿件中,或者通过其文献面板单条导入 BibTeX 与手动录入(详见官方文献帮助)。
假设我们在教学短稿中写下如下两段文字(包含一次同一来源的复用):
【原始稿件】
段落 1:基于自注意力机制的神经网络结构彻底改变了机器翻译任务的建模方式 [1]。
段落 2:在此基础上,研究者通过掩码语言模型实现了深层双向语言表征的预训练 [2]。这种表征学习依然建立在自注意力机制的基础之上 [1]。
此时,文献 A(Vaswani 等人)在段落 1 首次出现,被赋予编号 [1];文献 B(Devlin 等人)在段落 2 首次出现,获得编号 [2];段落 2 末尾复用文献 A 时,继续自动显示为 [1]。文后的参考文献列表顺序为:1. Vaswani 等人;2. Devlin 等人。
现在进行大修,我们将探讨预训练的“段落 2”整段移至“段落 1”之前:
【调序后稿件】
段落 2(现为第一段):在此基础上,研究者通过掩码语言模型实现了深层双向语言表征的预训练 [1]。这种表征学习依然建立在自注意力机制的基础之上 [2]。
段落 1(现为第二段):基于自注意力机制的神经网络结构彻底改变了机器翻译任务的建模方式 [2]。
观察此时的变化:
- 首次出现顺位改变:原本在段落 2 的文献 B 成了全文第一处引文,编号自动重排为
[1]; - 多处复用同步归并:文献 A 虽然在文末和第二段都有引用,但它在第一段句末首次被提及,因此被自动赋予编号
[2],后续第二段也统一显示为[2]; - 指向精准无误:正文中的
[1]或[2]弹出的依然是对应文献的真实标题与作者,文末参考文献表也同步调整了次序。
这种由系统维护的动态重排,保证了形式上“首次出现即对应文献表”的学术规范,作者无需进行繁琐的手动数字维护。
编号排对了,引用的证据还成立吗?
许多作者容易在此处产生一种虚假的安全感:既然编号自动理顺了,参考文献表也严格对应,改稿就万事大吉了吗?
答案是否定的。工具维系的是“正文标记与文献记录的对应关系”,但无法判定“文献内容是否支持你改写后的句子”。在论文大修中,最隐蔽、最致命的学术硬伤恰恰发生在文字改写与论据脱节之处。
来看一个典型的教学反例。假设在修改过程中,为了突出研究的重要性,作者将段落 1 的文字润色为:
“Vaswani 等人证明了基于自注意力机制的预训练架构在所有自然语言处理下游任务中均能取得最优性能 [2]。”
此时正文的 [2] 仍然准确绑定着 Vaswani 等人(2017)的论文,在格式与编号系统检查中完全绿灯。然而对照原文事实就会发现:Vaswani 等人在 2017 年的该篇论文中仅验证了机器翻译任务(WMT 2014 英德与英法翻译),根本未曾涉及“预训练”或“所有 NLP 下游任务”(这属于后来 BERT 等工作的内容)。这一改动导致论断严重超出了原文证据的覆盖范围。
如果作者使用了 AI 辅助改写(例如在 InkFount 中通过选区发起对话,查看修改前后对照并按需采纳,详见官方 AI 使用帮助),更需牢记:AI 能根据指令理顺句式或精简冗余,但绝不能替代作者对专业事实的审计。无论编号如何严丝合缝,引文字句的学术真实性永远只能由作者自行负责。
三步核查清单:把控大修后的引用质量
为了在大修后既享受自动编号的便捷,又守住学术论述的准确底线,建议作者在定稿前按以下三个层次进行清单化核查:
| 核查层级 | 核心关注点 | 核对动作与判定依据 |
|---|---|---|
| 第一步:查编号顺序(格式层) | 序列是否符合规范 | 检查正文引文是否从 [1] 开始连续递增;调换段落后,文后参考文献表次序是否已随之刷新。 |
| 第二步:查来源指向(元数据层) | 标记是否指对条目 | 点击或定位正文引用标记,核对绑定的文献标题、作者和年份,确认未在剪切粘贴中张冠李戴。 |
| 第三步:查内容支持(学术实质层) | 证据能否支撑新论断 | 对照改写后的具体句子,核查原文结论、测试范围或数值是否真实覆盖当前陈述,坚决剔除过度泛化的表述。 |
完成正文与引用的核实后,可以在 InkFount 导出面板 中选择对应语言的学术模板,直接导出整合了正文、图表、公式与参考文献列表的 PDF、Word 或 LaTeX 源代码交付文件。需要注意的是,具体支持的格式依所选模板而定,导出后仍建议通读一遍排版分页与引文呈现。
论文修改本质上是一场思维与材料的重新对齐。把繁琐的编号维护交给专业工具,把审慎的核验精力留给句子与证据本身,才能在大修与重组段落时胸有成竹。读者也可以在 InkFount 官网 打开一份测试稿件,亲自尝试调换几个段落,直观体会结构化写作工作台对学术引文的管理逻辑。
继续阅读
这些相关文章可以帮助你补齐写作流程中的其他环节。
论文导出成功就能交了吗?用源稿与成稿对照检查关键内容
论文导出成功不等于达到提交标准。本文以同一份小型学术样稿在 InkFount 中的导出案例为线索,梳理作者信息、图表公式、交叉引用及参考文献的源稿成稿四步对照法,阐述显示异常的源稿修正路径与匿名提交专项核验,帮助科研作者在交付前排除隐性差错。
论文结果怎么写:图表里的数字没错,文字为什么仍可能误导读者
论文结果段常陷入“数字无误却误导读者”的误区:文字遗漏比较基线,或把相关性夸大为因果。本文用一组教学实验数据,拆解结果段三层核对标准,演示在同一稿件中利用交叉引用保持图文编号联动,并向AI下达保留条件的修改指令与对比审阅。
论文讨论怎么写:遇到与预期不一致的结果,如何用文献展开解释
实验结果与预期冲突甚至反常下降时,讨论部分怎么写?本文通过一个真实文献支撑的教学案例,演示如何比对研究条件提炼解释,借助文献检索核对与带保留对照的AI润色,写出有证据、有边界的严谨学术讨论。
在 InkFount 中实践这套方法
你可以直接在编辑器里搭建提纲、管理参考文献、插入引用,并在导出前完成结构与格式检查。